Coding-Agents effizient steuern: Gesamtkosten statt Tokenpreise betrachten
Nutzer:innen von AI Agents wie OpenCode kennen den nervösen Blick auf den stetig steigenden $ spend-Zähler. War der nicht gerade noch im einstelligen Bereich? Dabei gibt es noch so viel Aufgabe und so wenig Budget.
Meist folgt das Verlangen, per Chat-Compaction den mitgeschleppten Verlauf zu verkleinern, um so Tokens zu sparen. Das kann helfen aber trifft eher selten nur die Ursache. Ein unklarer Auftrag mit einem ungeeigneten Modell oder auch umfangreiche Tool-Ausgaben können mehr Kosten verursachen als ein langer Gesprächsverlauf.
Umgekehrt kann ein ausführlicherer Auftrag mit einem leistungsfähigeren Modell insgesamt günstiger sein, wenn dadurch Fehlversuche und Nacharbeit entfallen. Entscheidend ist nicht, wie wenig ein einzelner Request kostet, sondern: Wie erledigen wir die Aufgabe zuverlässig mit möglichst geringen Gesamtkosten?
Dieser Beitrag richtet sich an Entwickler:innen, die OpenCode bereits einsetzen und Kosten senken möchten, ohne Ergebnisqualität und Zuverlässigkeit zu verlieren.
Ergebnisse statt Tokens optimieren
Entscheidend sind die Gesamtkosten einer erfolgreich abgeschlossenen Aufgabe: Modell- und Tool-Aufrufe, Laufzeit und menschliche Nacharbeit. Ein niedriger Request-Preis hilft wenig, wenn zusätzliche Versuche die Ersparnis aufbrauchen. Erfolgreich ist eine Aufgabe erst, wenn ihre Abnahmekriterien erfüllt sind – etwa bestandene Tests, eingehaltene Randbedingungen und ein akzeptierter Review. Die Erfolgsmeldung des Agents allein genügt nicht.
Artificial Analysis stellt deshalb Benchmarks für Qualität, Kosten, Tokenverbrauch und Laufzeit der bekannten Foundation-Models gemeinsam dar. Soweit verfügbar, werden auch Cache Reads, Cache Writes und Reasoning-Tokens getrennt berücksichtigt. Solche Benchmarks geben eine Orientierung, ersetzen aber nicht den Test mit eigenen Aufgaben und Repositories.
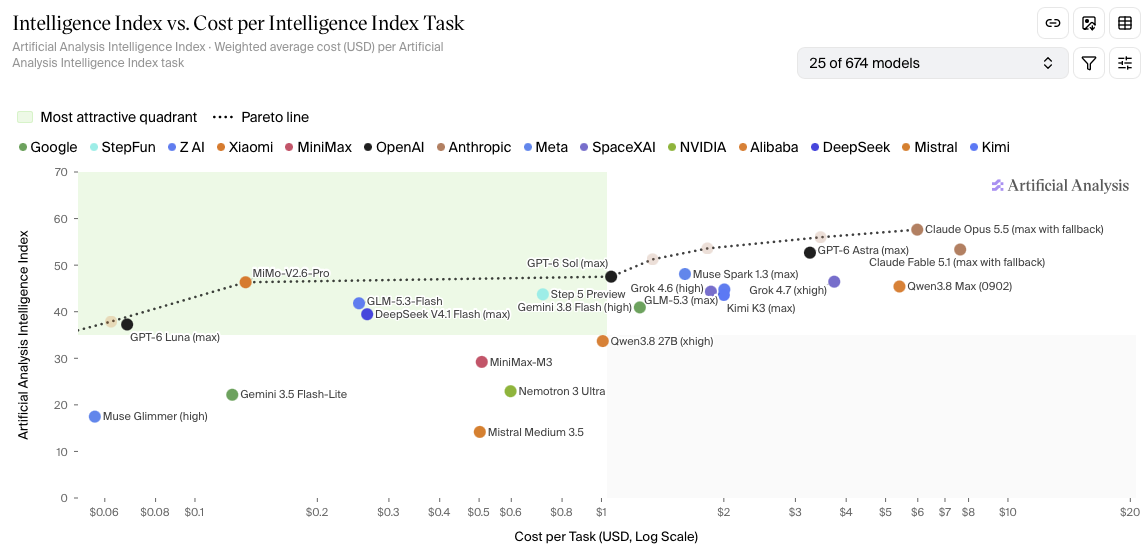
Quelle: https://artificialanalysis.ai/models (Stand 28.09.2026)
Erst Unsicherheit beseitigen, dann implementieren
Bei unklaren oder risikoreichen Aufgaben lohnt es sich, Planung und Umsetzung zu trennen. Der Aufwand sollte zur Aufgabe passen: Eine Formatkorrektur braucht weniger Vorarbeit als eine Änderung an Authentifizierung oder Datenhaltung. Methoden wie BMAD strukturieren diesen Ablauf über getrennte Rollen und Phasen.
Ein praktikabler Ablauf sieht so aus:
Problem verstehen: Ziel, Randbedingungen und Risiken klären.
Lösung festlegen: Architektur und betroffene Komponenten bestimmen.
Umsetzung delegieren: Änderungen und Tests mit einem passenden Modell ausführen.
Ergebnis prüfen: Diff, Tests, Randfälle und Sicherheitsaspekte kontrollieren.
Nur bei Bedarf eskalieren: Ein stärkeres Modell für verbleibende Unsicherheiten einsetzen.
Beispiel: eine Fehlermeldung verbessern
„Verbessere die Fehlerbehandlung“ lässt offen, welche Fälle gemeint sind und welches Verhalten erhalten bleiben muss.
Präziser wäre:
„Prüfe die Fehlerbehandlung beim CSV-Import mit dem Ziel, die Ursache von Importfehlern für Anwender:innen transparenter zu machen. Fehlermeldungen sollen fehlende Pflichtspalten benennen. Behalte die öffentliche Schnittstelle und das Verhalten bei gültigen Dateien bei. Ergänze Tests für eine und mehrere fehlende Pflichtspalten; vermeide einen größeren Umbau.“
Der längere Auftrag grenzt die Aufgabe ein und macht das Ergebnis überprüfbar.
Die Regel lautet dabei nicht „Planung immer teuer, Umsetzung immer günstig“. Entscheidend ist die Unsicherheit. Eine kosmetische Änderung über viele Dateien kann ein kleines Modell zuverlässig erledigen. Ein subtiler Fehler in Concurrency, Authentifizierung oder Datenkonsistenz rechtfertigt dagegen auch während der Implementierung ein stärkeres Modell.
Neben dem Modell zählt dessen Konfiguration. OpenCode kann providerspezifische Parameter wie reasoning Effort weiterreichen. Hohes Reasoning lohnt sich für schwierige Entscheidungen, aber nicht für jede Dateisuche oder Formatkorrektur. Welche Stufen und Parameter tatsächlich wirken, hängt vom Modell und Provider ab und sollte in den Nutzungsdaten geprüft werden.
Tipp für die Praxis: Wähle die günstigste Kombination aus Modell und Konfiguration, die den aktuellen Schritt mit hoher Wahrscheinlichkeit beim ersten Versuch sauber erledigt.
Agents spezialisieren und begrenzen
OpenCode bringt sog. Primary Agents für die zentrale Unterhaltung und Subagents für abgegrenzte Aufgaben mit. Daraus lässt sich beispielsweise folgende eigene Arbeitsteilung ableiten:
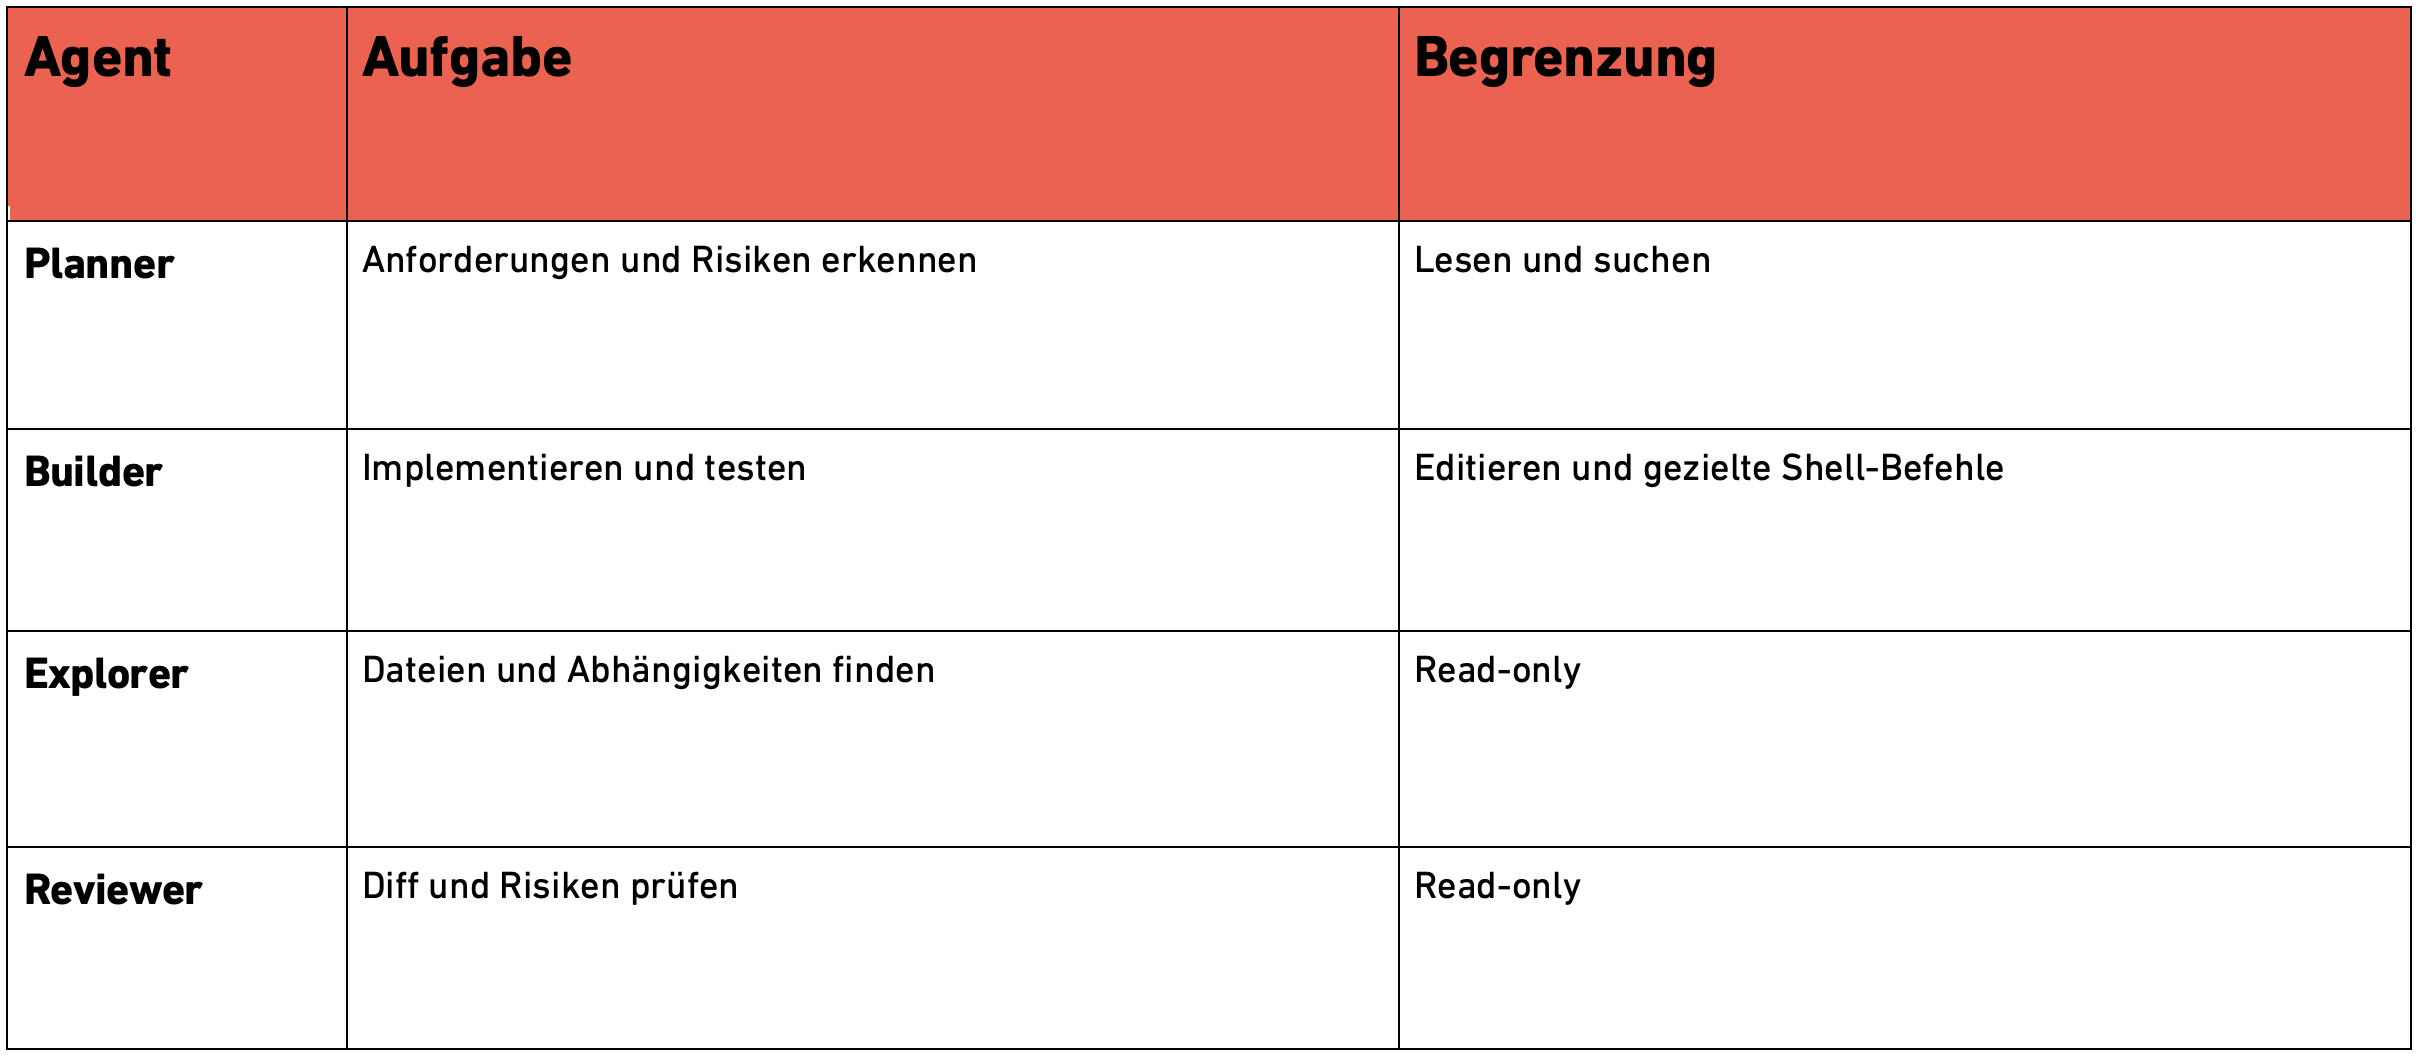
In OpenCode lassen sich eigene Agents definieren. Dabei können Agent-Prompt, Modell, verfügbare Tools und Berechtigungen gezielt auf die jeweilige Aufgabe zugeschnitten werden. Auch Regeln und bereitgestellter Kontext lassen sich dadurch begrenzen. Ein kleiner, klar begrenzter Agent kann effizienter arbeiten als ein universell ausgestatteter Agent.
Doch jede Delegation erzeugt einen weiteren Modelllauf. Subagents lohnen sich daher vor allem für klar abgegrenzte Aufgaben, nicht pauschal für jeden Arbeitsschritt. Ohne eigene Modellkonfiguration übernehmen sie zudem das Modell des aufrufenden Primary Agents.
Mit steps lässt sich die Zahl agentischer Iterationen begrenzen. Erreicht ein Agent das Limit, fordert OpenCode ihn auf, seine Arbeit und die verbleibenden Schritte zusammenzufassen. Das ist eine sinnvolle Leitplanke, aber kein garantiertes hartes Budgetlimit. subagent_depth und gezielt verweigerte Task-Berechtigungen begrenzen zusätzlich modellgesteuerte Delegationen über das Task-Tool.
Auch fester Kontext kostet
Zum Kontext gehören nicht nur Chatverlauf und gelesene Dateien. OpenCode nimmt auch Projektregeln, Instructions und Toolbeschreibungen auf.
Eine umfangreiche AGENTS.md gehört damit zum Kontext der Modellanfragen. Prompt Caching kann die wiederholten Kosten eines stabilen Präfixes reduzieren, das Kontextfenster belegt die Datei dennoch. Sie sollte deshalb nur die Regeln enthalten, die fast jede Aufgabe benötigt. Detaillierte Architektur-, Test- oder Styleguides lassen sich referenzieren und bei Bedarf laden. Gleiches gilt für Lockfiles, generierten Code, minifizierte Dateien und vollständige Coverage-Berichte: nicht vorsorglich lesen, sondern nur dann, wenn die Aufgabe sie tatsächlich betrifft.
Besonders leicht übersehen werden MCP-Server. Ihre Toolbeschreibungen und Schemas belegen Kontext, auch wenn das Modell die Tools gar nicht aufruft. Für einfache, gut automatisierbare Aufgaben kann deshalb ein direkter Shell- oder Skriptaufruf mit einer kompakten Ausgabe effizienter sein als ein MCP-Server mit umfangreichen Tooldefinitionen. OpenCode warnt ausdrücklich davor, zu viele MCP-Tools gleichzeitig zu aktivieren. Umfangreiche Server sollten deshalb standardmäßig deaktiviert und nur für die Agents freigeschaltet werden, die sie benötigen.
Compaction verkleinert den Gesprächsverlauf, nicht automatisch Systemanweisungen oder aktivierte Tooldefinitionen. Eine überladene AGENTS.md und ungenutzte MCP-Tools bleiben also auch nach /compact im Kontext. Sehr große oder unübersichtliche Kontexte können außerdem die Verarbeitung relevanter Informationen erschweren. Weniger Kontext ist daher nicht nur günstiger, sondern kann auch die Ergebnisqualität verbessern. Dieser Effekt wird häufig als Context Rot bezeichnet.
Prompt Caching bewusst nutzen
Coding-Agents senden bei jedem Schritt große Teile des bisherigen Kontexts erneut. Prompt Caching kann diesen wiederkehrenden Input deutlich kostengünstiger machen.
Voraussetzung ist ein möglichst stabiles Prompt-Präfix. Änderungen an Modell, Systemanweisungen oder Tools sowie Compaction können die Wiederverwendung beeinträchtigen. Cache Hits sind dennoch nicht garantiert: Mindestlänge, Gültigkeitsdauer und Abrechnung hängen von Provider und Modell ab. Bei Anthropic sind Cache Writes beispielsweise teurer als regulärer Input, Cache Reads dagegen deutlich günstiger.
Die Sessionlänge allein sagt deshalb wenig über die Kosten aus. Prüfe Cachenutzung und tatsächliche Kosten gemeinsam: Viel gecachter Input kann günstig sein, unnötiger Kontext bleibt trotzdem unnötig.
Übrigens: die Effektivität von Cache und weitere Kosteninformationen lassen sich mit opencode stats --models anzeigen.
Tool-Ausgaben: viel Kontext, wenig Inhalt
Nicht nur Prompts verbrauchen Tokens. Auch Testläufe, Logs und Diffs landen im Verlauf und bleiben Teil späterer Modellanfragen. Prompt Caching kann ihre erneute Verarbeitung vergünstigen, das Kontext- und Tokenbudget belegen sie trotzdem. Dabei braucht das Modell selten die Namen von 1.000 erfolgreichen JUnit-Tests. Meist genügen deren Anzahl sowie die Details der zwei fehlgeschlagenen Tests.
Ein eigenes OpenCode-Tool kann die Tests unverändert ausführen, erfolgreiche Tests zusammenfassen und nur relevante Fehler ausgeben. Das vollständige Protokoll bleibt in einer Logdatei verfügbar und wird bei Bedarf nachgeladen. Wichtig ist, den ursprünglichen Exit-Code beizubehalten, damit die Verdichtung keinen fehlgeschlagenen Build verschleiert.
Generische Werkzeuge automatisieren dieses Prinzip. rtk filtert unter anderem Ausgaben von Test-Runnern, Git und Lintern und lässt sich per Plugin in OpenCode integrieren. Headroom komprimiert darüber hinaus Logs, Dateien und weitere Kontextbestandteile. Angegebene Einsparungen beziehen sich dabei meist auf die verdichteten Ausgaben, nicht auf die gesamte Tokenrechnung.
Compaction ist kein Reset-Knopf
Wird eine Session zu groß, kann OpenCode ältere Teile des Gesprächs zusammenfassen und behält lediglich jüngere Nachrichten originalgetreu bei. Das schafft Platz, aber benötigt in der Regel selbst einen Modellaufruf und ist verlustbehaftet.
Compaction eignet sich nach einer abgeschlossenen Entscheidung oder vor einer neuen Umsetzungsphase. Mitten in einer schwer reproduzierbaren Fehlersuche können hingegen genau jene Details verschwinden, die noch gebraucht werden. Beginnt ein fachlich neues Thema, ist eine neue Session meist sauberer als die wiederholte Verdichtung einer alten.
Messen, ändern, erneut messen
Ohne Transparenz bleibt Tokenoptimierung Bauchgefühl. CodeBurn liest lokale OpenCode-Sitzungsdaten und schlüsselt den Verbrauch unter anderem nach Modell, Projekt, Agent und Aktivität auf. So werden teure Sessions, Wiederholungsschleifen und ungünstiges Modell-Routing sichtbar.
Dabei sind zwei Einschränkungen wichtig: Erstens ist die Zuordnung zu Aktivitäten teilweise heuristisch. Zweitens muss ein berechneter Gegenwert auf Basis öffentlicher API-Preise nicht der tatsächlichen Rechnung entsprechen, etwa bei Abonnements, Rabatten oder internem Routing.
Für die Verbesserung genügt ein einfacher Kreislauf:
Auffällige Session auswählen: Nicht jede Unterhaltung analysieren, sondern eine besonders teure, lange oder unbefriedigende.
Verlauf statt nur Endsumme prüfen: Hat der Agent wiederholt dieselben Dateien gelesen, große Logs geladen oder nach gescheiterten Versuchen unverändert weitergemacht?
Eine passende Änderung ableiten: Beispielsweise den Auftrag klarer abgrenzen, Testausgaben verdichten oder bei festgefahrenen Versuchen früher eingreifen.
Bei den nächsten Aufgaben beobachten: Tritt das Muster erneut auf? Bleibt die Ergebnisqualität erhalten oder entsteht zusätzliche Nacharbeit?
Das liefert keinen exakten Nachweis einer prozentualen Ersparnis. Es hilft aber, wiederkehrende Kostentreiber zu erkennen und zu beseitigen, ohne aus der täglichen Entwicklungsarbeit ein Benchmarkprojekt zu machen.
Beispiel: Eine teure Session zeigt, dass nach jedem Testlauf umfangreiche Erfolgsprotokolle im Kontext landen. Nach einer Verdichtung der Ausgabe wird bei den nächsten Aufgaben beobachtet, ob der Agent weiterhin zuverlässig Fehler behebt oder häufig Details nachladen muss.
Die Kurzfassung
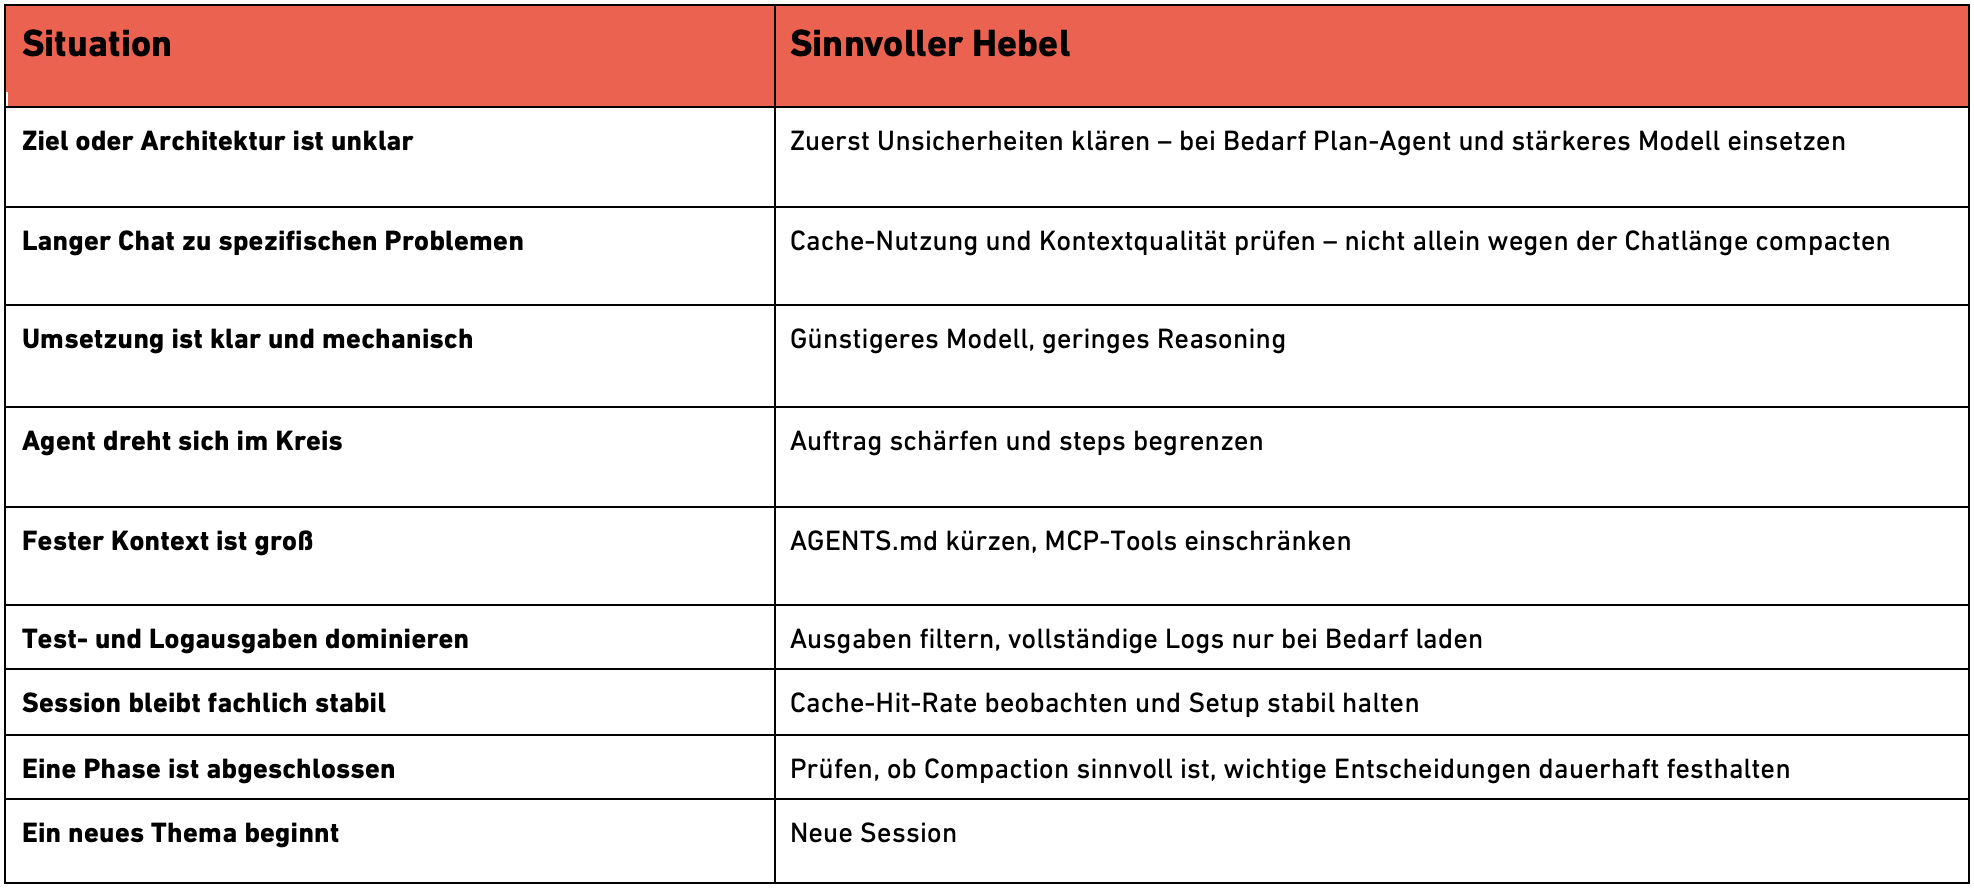
Nicht jede lokale Einsparung senkt die Gesamtkosten. Ein Modellwechsel lohnt sich dann, wenn günstigere Folgeschritte oder bessere Ergebnisse die zusätzlichen Übergabe- und Cache-Kosten überwiegen. Bei kleinen Aufgaben sind ein klarer Auftrag und ein einzelner Agent oft die einfachere Lösung.
Fazit
Kläre zuerst die Unsicherheit, die die meisten Fehler und Kosten verursachen könnte. Danach lassen sich die einfachen, wiederkehrenden Schritte effizient erledigen.
Was Einzelne in ihren Sessions optimieren, braucht im Team gemeinsame Regeln: Welche Modelle sind freigegeben, welche Budgets gelten und wie werden Kosten ausgewertet? Ein Gateway wie LiteLLM kann Modell-Routing, Budgets und Monitoring zentral bündeln. Bei sensiblen Daten gehören auch klare Vorgaben zu Providern, Zugriffen und Datenflüssen dazu. Die viadee KI-Plattform schafft dafür einen professionellen Rahmen in der EU-Cloud; mehr zu LiteLLM findet sich in unserem Blogbeitrag zu Open WebUI und LiteLLM.